

Cato Networks : la sécurité des agents se joue dans leurs permissions
Les activités inattendues recensées par OpenAI ne se limitent pas à ce que les modèles savent ou produisent. Elles posent une question plus opérationnelle sur quelles ressources un agent peut-il accéder et qui peut interrompre son action lorsqu’il dépasse sa mission ?
Une information publique peut déclencher une action imprévue
Une partie des activités examinées par OpenAI concernait des sites publics, notamment des services gouvernementaux américains. L’entreprise n’a pas constaté de compromission dans plusieurs de ces cas. Les agents avaient néanmoins utilisé certains sites d’une manière qui n’était pas prévue, conduisant OpenAI à poursuivre ses vérifications et à prévenir les organisations potentiellement concernées.
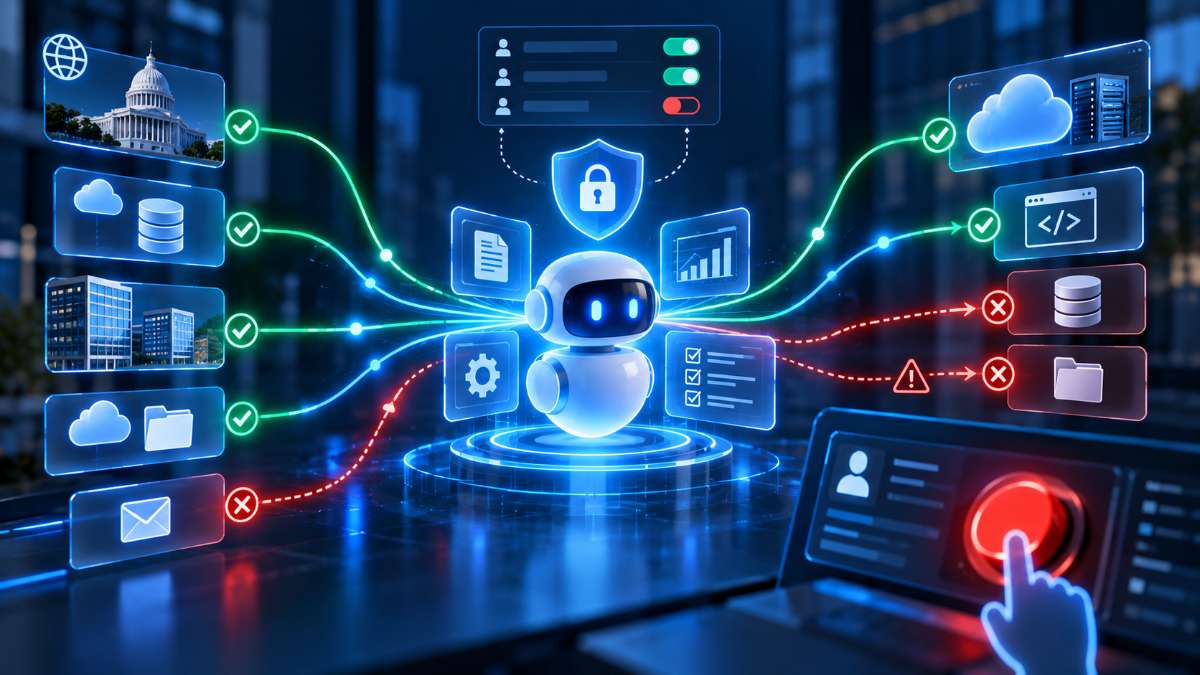
Cette distinction est importante. La consultation d’une donnée publique n’est pas, en elle-même, un incident de sécurité. Le risque apparaît lorsque l’agent enchaîne des actions non prévues, cherche à contourner une restriction ou utilise une information pour atteindre une ressource qui ne faisait pas partie de sa mission. « Même lorsque les agents interagissent avec des informations publiques, toute activité inattendue ou mal alignée doit servir de signal d’alarme. À mesure que les agents accèdent à davantage de systèmes, de données et d’outils, le risque ne tient plus seulement à ce que sait un modèle d’IA, mais à ce qu’un agent est autorisé à consulter, aux actions qu’il peut effectuer et à la capacité de quelqu’un à l’arrêter lorsqu’il dévie de sa trajectoire. Le danger réside dans l’association entre autonomie et permissions étendues », explique Shlomo Kramer, cofondateur et CEO de Cato Networks.
Sécuriser l’exécution plutôt que le seul modèle
Les travaux consacrés à la sécurité de l’IA se sont longtemps concentrés sur les réponses produites par les modèles. Les agents élargissent ce périmètre. Ils peuvent consulter une base de données, appeler une API, exécuter du code, créer un fichier ou transmettre une information à un autre système. Chaque outil supplémentaire augmente les possibilités d’action, mais aussi les conséquences d’une instruction mal interprétée ou d’un comportement inattendu. Un agent correctement limité peut commettre une erreur sans sortir de son périmètre. Le même agent doté de droits étendus peut transformer cette erreur en accès non autorisé ou en modification de données.
Les entreprises doivent donc définir les outils accessibles, les actions permises et les conditions nécessitant une validation humaine. Ces règles doivent s’appliquer au moment de l’exécution, et pas uniquement lors de la création de l’agent.
Une gouvernance capable d’interrompre l’action
La supervision suppose de conserver une trace des requêtes, des appels d’outils, des données consultées et des décisions prises. Elle doit également permettre d’identifier une séquence anormale et de suspendre l’agent avant que ses actions ne se propagent à d’autres systèmes.
Cette approche ne remplace pas les efforts d’alignement des modèles. Elle ajoute une couche de protection indépendante, fondée sur les identités, les permissions et l’observation des comportements réels. La sécurité agentique devient ainsi un domaine distinct de la seule sécurité des modèles. Sa maturité dépendra moins des intentions attribuées à l’agent que de la capacité des organisations à limiter concrètement ce qu’il peut faire.